コンテンツにスキップ

AHC

タグ「AHC」の記事 4 件

AtCoder Heuristic Contest 030 参加記

AtCoder Heuristic Contest 030に参加し、275位でした。

なるべく早くサンプルを提出するチャレンジです。(無意味) 負けました。問題を開くのが少なく見積もって3秒は遅れていたのが敗因です。

サンプルと同じことをするコードを今後の修正を加味しながらきれいに書き直します。この中でコストの計算方法の理解が正しいかなどを確認していきます。

https://atcoder.jp/contests/ahc030/submissions/50121556
絶対スコア:12696000000

∑t=150N2=12696\sum_{t=1}^{50} {N}^2 = 12696
であることがわかりますね。

方針が立たないので適当にq1のクエリを繰り返しながら明らかに確定したタイミングで答えを決める形にします。 答えが確定したかを確認するのを O(N2 d M) かけるとして全部で O(N4 d M) 。間に合います。 答えが確定したかは、0の場所と被らずに油田を置けるかの判定を全ての油田について行います。(かなり簡易な判定)

https://atcoder.jp/contests/ahc030/submissions/50122609
絶対スコア:11981000000

微差ですね。

油田の数が多くなるとほとんど判定が効いていないようです。特定のマスについて、そこに被るように置く方法が1通りであるかの判定を追加します。

https://atcoder.jp/contests/ahc030/submissions/50123560
絶対スコア:10678000000

多くのケースにおいて全て埋めきる前に確定させられるようになりました。 実行時間が1.2sだったので、そろそろ気にする必要がありそうです。

(2024-02-10T12:00:00+09:00)

2段になっておりサンプルの上に1段あります。 既にここは超えていますが、見逃している自明解があるようなので、これを探ってみます。

発見しました。サンプルと同じように進めて、見つかっているものの総和を比べると、ここになるようです。

https://atcoder.jp/contests/ahc030/submissions/50127581
絶対スコア:11411000000

稀に全てのセルを探索しているので、組み合わせると改善するはず。

https://atcoder.jp/contests/ahc030/submissions/50127994
絶対スコア:10220000000

実行時間を改善するためグリッドを一次元化したりいろいろ工夫します。判定をいろいろ賢くして、まだ調べていない部分も確定する部分をちゃんと記録して、調べるときはそれを除くようにします。 かなり掘る回数を削減できました。

この過程で500回に1回くらいの確率でWAになるバグを見つけました。再現性がないとデバッグで困るのでrandom関数は決定的なものにしておいた方がいい気がします。

https://atcoder.jp/contests/ahc030/submissions/50255771
絶対スコア:5415000000

掘る場所を改善できる気がします。掘る候補についてそこを掘ったときに得られる情報量を考えて、エントロピーを計算すれば、いい場所を掘るようになりそうです。ただ、実装が面倒だし、TLEになる気もします。

同じ形の油田が2つあるとそのどちらなのかが特定できません。このようなケースがだいたい7.5%ほどあります。2つあるなら2択まで絞れた時点でどちらかに決めるような処理を入れました。

候補が複数あるものを適当に決めて矛盾があれば候補からはずす

Section titled “候補が複数あるものを適当に決めて矛盾があれば候補からはずす”

やりすぎるとすぐTLEするので候補が多いものに絞った上で、残り時間が少ないと判定を飛ばすようにした。

確定していないものから一様ランダムに選んでいたが、確定している場所の近くは選ばれにくくした。

https://atcoder.jp/contests/ahc030/submissions/50275514
絶対スコア:4957000000

結局占いは使えませんでした…
AtCoder Heuristic Contest 027 参加記

AtCoder Heuristic Contest 027に参加し、273位でした。

サンプルのdfsと同じものを実装する。 スコアの計算を実装する。

以下、特に明記しない場合はシードが1~100のときの平均
Average = 21991473.54

24通りを試し、最良を選択する

Average = 19521742.3

各マスでランダムに優先順位を決める。 20000回程シミュレーションできた。

Average = 21251525.91

あんまりよくなっていない

ちょっと寄り道したり、省略したりしてみて改善するなら採用を繰り返す。変化が小さいのですぐに局所解になったり、広い盤面だと計算に時間がかかって十分に派生させられないので、いろいろ残念。大きい変化を頑張って採用できるようにする案もあるが、次の手に。

Average = 18365379.48

15000000くらいなら提出する気になるかな…

DFSは実装が簡単だが、無駄な移動が多い。 なるべく少ない移動ですべてのマスを少なくとも一回通る方法について考える。 これは巡回セールスマン問題(TSP)なので、条件つきでの近似解法について調べる。 三角不等式が成り立つときの問題をMetric TSPというらしい。 この条件下ではDFSのルートから既に行ったことのある場所をとばしてルートを決定していくというのがあるらしい。 クリストフィードのアルゴリズムはよくわからなかった。O(n3)らしいので今回の条件だと使えない? RDLUの順に評価するDFSを変形する形で実装してみる。

Average = 16936320.88

思ったより改善した

Average = 16144839.97

まだTSPが不完全…。 グリッド上のTSP解法は確実に論文があるはずだが、検索能力がないので見つけられない。 Bing AIにきいてみるとFutureの記事を提案されるがこれは一般的なグラフの解法。 食い下がると、次数5以下の場合の多項式時間アルゴリズムを出してくれる。そんなものが存在するのか…。英語論文を読む気にならない

Average = 15892483.36

とりあえずTSPは十分と思って、ここから適当に遷移させる。

Average = 14025677.55

結構改善した

汚れが大きいところを通るものを選ぶようにする

Average = 13801249.45

局所最適解に陥ることが多い

TSPの後、改善する手順を繰り返す。 改善する段階は重みをつけているので一意だが、TSP解がランダムなのでいろいろな解がえられる。

Average = 13567886.96

そもそもTSPが最適でないし、多様性もない

TSPの最善でないものもいろいろ採用してみる

Average = 13178283.81

Average = 13213827.0

収束の速いケースでは改善したが全体としては悪化

入力生成方法を読むと、1~20の汚れやすいゾーンがある。汚れやすい場所でないところは10以下で汚れやすい場所は最大1000なので、かなり差がある。実際どのくらいかわからないが、汚れやすい場所をそうでない場所の10倍以上通るくらいがよさそう?

10より大きい場所だけでTSPを解けばいいのでは?

間に合わず 悲しい

結構いいアイディアが思いついたと思ったけど、実装しきれず… 参加賞が200人対象なので頑張ったが、さすがに届いてなさそう

AtCoder Heuristic Contest 025 参加記

AtCoder Heuristic Contest 025に参加し、185位でした。

d[i] = i % D

とする。 https://atcoder.jp/contests/ahc025/submissions/46619584

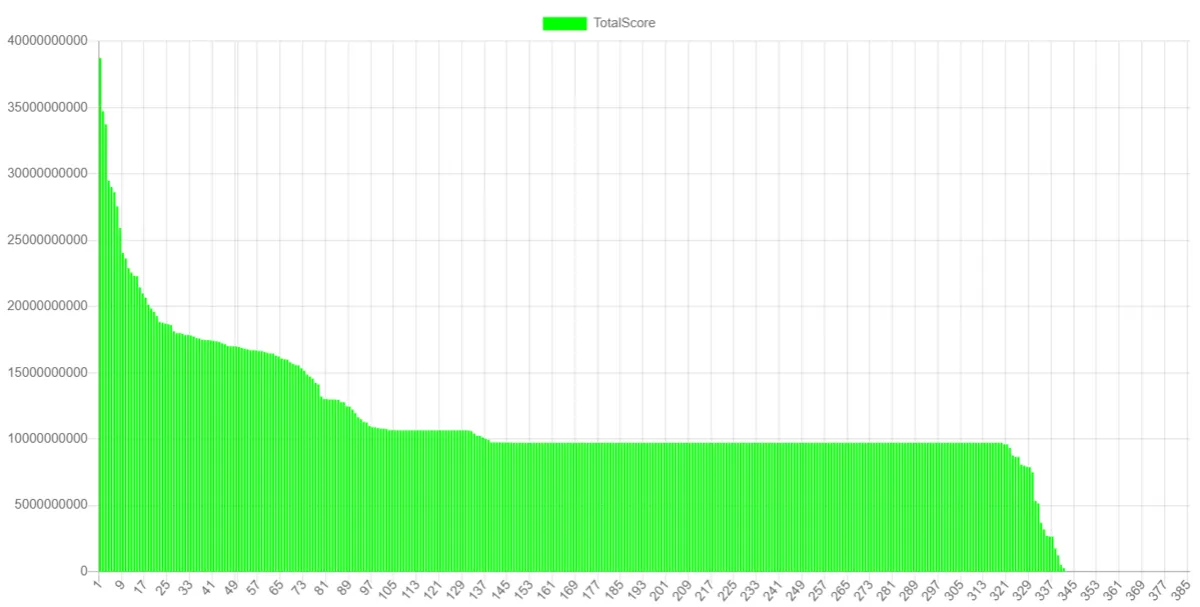
AHCの順位表は作戦立てに有効な情報が多いので視覚的に把握できると便利です
例えば今日開催されたAHC024では現時点(10/13, 12:54)では10位付近に強い貪欲があるのがわかります。 pic.twitter.com/ndFWFVUZff

— pitP (@HISHO_NO_KISEKI) 2023年10月14日

上の並んでいる部分。みんな考えることは同じやね。

原型を改良する方向で考える。Dが大きいときは、ソートして最小と最大を近づければそれっぽくなりそう。

2≤D≤25,2 \le D \le 25, 8D≤Q≤1600D,8D \le Q \le 1600D,

Qが最小のときでもギリギリ、ソート出来そう。

ソートの候補は

  • マージソート
  • クイックソート
  • ヒープソート
  • 二分挿入ソート

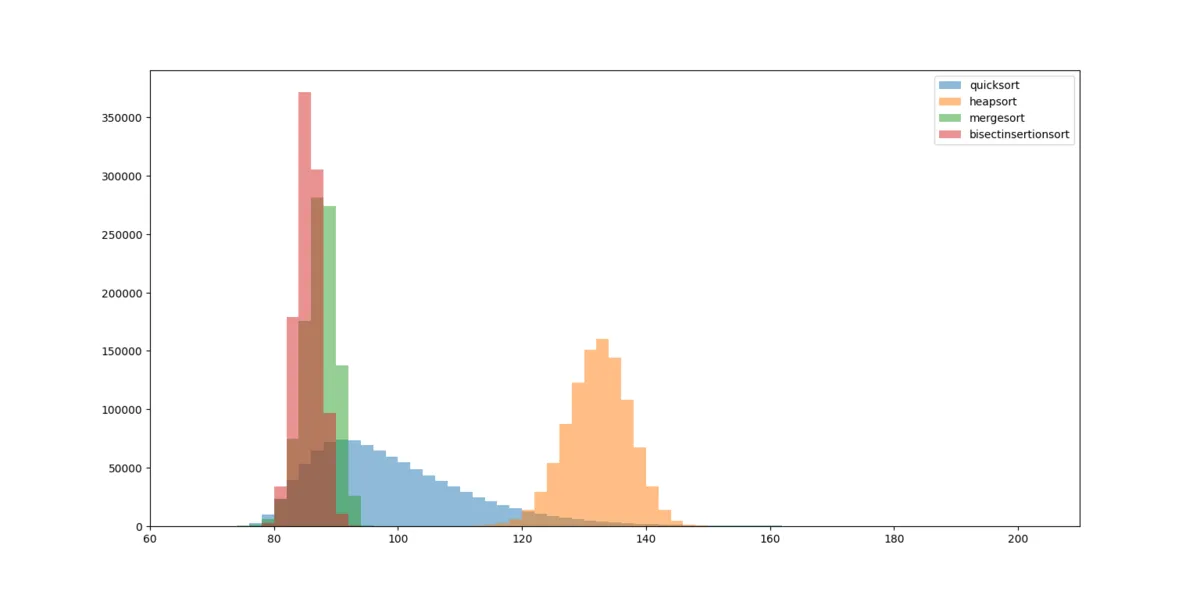
要素数25(一致する数字はなし)で、それぞれ106回実行したときの比較回数。

二分挿入ソートは挿入ソートの挿入位置を二分探索で求めるもの。通常、挿入コストが重いので使われないが、比較コストはこの中で最も低いようだ。

最悪でも要素数の4倍未満なので必ずソート出来る。

N = 25
t = 0
for i in range(1, N):
t += i.bit_length()
print(t) # 94

最悪の比較回数は上のコードで求まる。

Qが小さいのでちゃんと最適な質問の仕方をしたい。

x≤y∧y≤z→x≤zx \le y \land y \le z \to x \le z Weight⁡{a}≤Weight⁡{b}↔Weight⁡{a,c}≤Weight⁡{b,c}\operatorname{Weight} \{ a \} \le \operatorname{Weight} \{ b \} \leftrightarrow \operatorname{Weight} \{ a,c \} \le \operatorname{Weight} \{ b,c \}

みたいな性質は使いたい。

ソートしたあと上と下を近づける

Section titled “ソートしたあと上と下を近づける”

大小関係についてきちんと保存して、上記の性質を利用して無駄なクエリを排除するコードを書いてみたものの、うまく動かなかったので、実装コストの軽い方針で進める。 はじめに二分挿入ソートでソートしたあと、要素が2つ以上のなるべく大きいグループからランダムに1つ選び、最も小さいグループに移動させる。これで改善する場合は採用し、新しいグループの挿入位置を二分探索で調べる。

提出 https://atcoder.jp/contests/ahc025/submissions/46724103

結構いいスコア

上の方法では最も大きいグループのどれを移動させても改善しない状態に収束するので、収束が確認できたら初期解をランダムに作成し同じ操作をする。新しく作った解の最大最小のグループを元の解のものと比べて、どちらも改善しているなら採用する

提出 Submission #46742799 - AtCoder Heuristic Contest 025

収束するまでの操作は回しきれないものから30回程のものまである

シード0~999の1000ケースについて--D=2で実験してみたところスコアの平均は31858.2だった。

解の探索範囲を広げるため、大きい方から小さい方に動かして悪化する場合もそれを採用することにした。スコアの平均は57360.4だった。 悪化する場合は選択せずに選び直すという処理はよかったようだ。

単に2つを比べて近づけていくのはあんまり賢くない気がするが特によい方法が思いつかない。

問題の都合上、少し改善が難しい。力を出し切った感覚はないが、十分なスコアは出ていそうだし、疲れたのでここで終了。結局3回しか提出しなかった。

AtCoder Heuristic Contest 022 参加記

AtCoder Heuristic Contest 022に参加し、442位でした。

AtCoderはshogo314でやってます。現在のHeuristicレートは1279です。正直アルゴに比べて苦手意識があります。

多くのテストケースで実行してくれるようにする。

  • i番目の出口セルの位置についてPの値を10∗iに、出口セルが存在しない位置は0に設定する
  • 各ワームホールについて、y=0,x=0で1回計測し、出口セルの中でPの値が計測値と最も近いものを推定結果として回答する

シードが0~99のときの平均
Score = 61006.45
Number of wrong answers = 70.54
Placement cost = 58216412.0
Measurement cost = 80050.0
Measurement count = 80.05

とりあえず100回にする。

Score = 193196.03
Number of wrong answers = 54.96
Placement cost = 58216412.0
Measurement cost = 8005000.0
Measurement count = 8005.0

  1. 出口セルがないところについて始め0にする。
  2. その場所と上下左右の5つの平均に変更する。 2の更新を収束するまで繰り返す。高々500回で収束した。
    この方法は結構悩んで思いついた。

Score = 1043108.47
Number of wrong answers = 54.96
Placement cost = 4380140.38
Measurement cost = 8005000.0
Measurement count = 8005.0

シード0

出口セルははじめ、ソートされているためそこそこ綺麗にならんでいるが、最適ではない。

(0,0)に近いセル程温度が小さくなるようにした。

Score = 1273992.77
Number of wrong answers = 54.87
Placement cost = 2189832.44
Measurement cost = 8005000.0
Measurement count = 8005.0

提出したときの得点が46665734。
https://atcoder.jp/contests/ahc022/submissions/44593554

現在、計測コストの方が配置コストより大きいので、不要な計測を減らす。

計測回数1回(シード0~99)
Score = 46539724.16
Number of wrong answers = 0.0
Placement cost = 2184762.94
Measurement cost = 80050.0
Measurement count = 80.05

十分余裕がありそうなので出口セルごとの10度の差を狭める

差45678910
Score58501072.9111642068.9294756777.7383280013.7867687172.4455751381.5546539724.16
Number of wrong answers5.620.970.520.040.010.00.0

5を採用

Score = 111642068.92
Number of wrong answers = 0.97
Placement cost = 606090.1
Measurement cost = 80050.0
Measurement count = 80.05

計測回数と差で3分探索
計測回数10、差7にする

Score = 46035178.9
Number of wrong answers = 0.69
Placement cost = 1112203.54
Measurement cost = 800500.0
Measurement count = 800.5

計測回数30、差9にする

Score = 21359258.4
Number of wrong answers = 0.69
Placement cost = 1785155.8
Measurement cost = 2401500.0
Measurement count = 2401.5

差はなるべく大きくなるよう1000/Nとし、計測回数は差が大きいほど小さくなるよう600/(1000/N)とした

Score = 11425781.84
Number of wrong answers = 1.33
Placement cost = 3018406.44
Measurement cost = 4068960.0
Measurement count = 4068.96

差はなるべく大きくなるよう1000/Nとし、計測回数はmin(10000 / N, 1280 / (1000 / N))とした。

Score = 5487954.38
Number of wrong answers = 2.92
Placement cost = 3018406.44
Measurement cost = 8099700.0
Measurement count = 8099.7

差はなるべく大きくなるよう1000/Nとし、計測回数はなるべく大きくなるよう600/(1000/N)とした。

S = 36
Score = 2139835.28
Number of wrong answers = 9.35
Placement cost = 3018406.44
Measurement cost = 9961740.0
Measurement count = 9961.74

シード0~99
Score = 6659829.24
Number of wrong answers = 53.56
Placement cost = 2855445.76
Measurement cost = 8864140.0
Measurement count = 8864.14

シードが大きいときはコストが大きいが正答率が上がり、シードが小さいときは正答率をあまり下げずにコストを大きく減らせた。
提出したときの得点が171125470。ここまで出来たら水perfはありそう。
https://atcoder.jp/contests/ahc022/submissions/44599076

出口セルの右側のセルも計測する

Section titled “出口セルの右側のセルも計測する”

出口セルの部分だけを計測する戦略だとそろそろ限界が近い(SだけでなくLやNで場合わけして調節すれば、おそらくもう少しだけ上げられる)。

S=100にして調べる。
Score = 5161.73
Number of wrong answers = 45.89
Placement cost = 3018406.44
Measurement cost = 9961740.0
Measurement count = 9961.74

これの改善を目標にする。
最大100段階にわけるため、差が10しかなく、標準偏差が100もあると100回計測しても区別できなくなってしまうのが問題である。

出口セルの右側のセルにも意味のある数字を設定することにする。
温度を100段階にわけていたのを右側も含めて10×10段階にする。
右側に出口セルが既にあり設定出来ない場合は無視する。

S=100
シード0
以前

以後
Score = 871116.64
Number of wrong answers = 8.1
Placement cost = 29694576.56
Measurement cost = 8405250.0
Measurement count = 8005.0

よさげ
S>=49のときはこちらを採用することにする。

Score = 6862727.85
Number of wrong answers = 41.5
Placement cost = 23144140.46
Measurement cost = 7641190.0
Measurement count = 7338.94

提出したときの得点が184347800。
https://atcoder.jp/contests/ahc022/submissions/44603614
おそらくSが大きいときは不十分。

正規分布のあたりの知識が欠落しているので実際に確かめながらやってみる。
正規分布から値をサンプリングする関数はモダンな言語なら大抵用意されている。

正規分布から値をサンプリング

Section titled “正規分布から値をサンプリング”
コード
import numpy as np
import matplotlib.pyplot as plt
dataSize = np.int64(1e5)
sigma = np.float64(1)
noise = np.random.normal(0.0, sigma, dataSize)
plt.figure()
plt.hist(noise, bins=100, density=True, color="b")
x = np.arange(-5, 5, 0.01)
gauss = 1/np.sqrt(2*np.pi*sigma**2)*np.exp(-x*x/(2*sigma**2))
plt.plot(x, gauss, "r--")
plt.xlabel('Deviation')
plt.ylabel('Density')
plt.show()